きっかけ
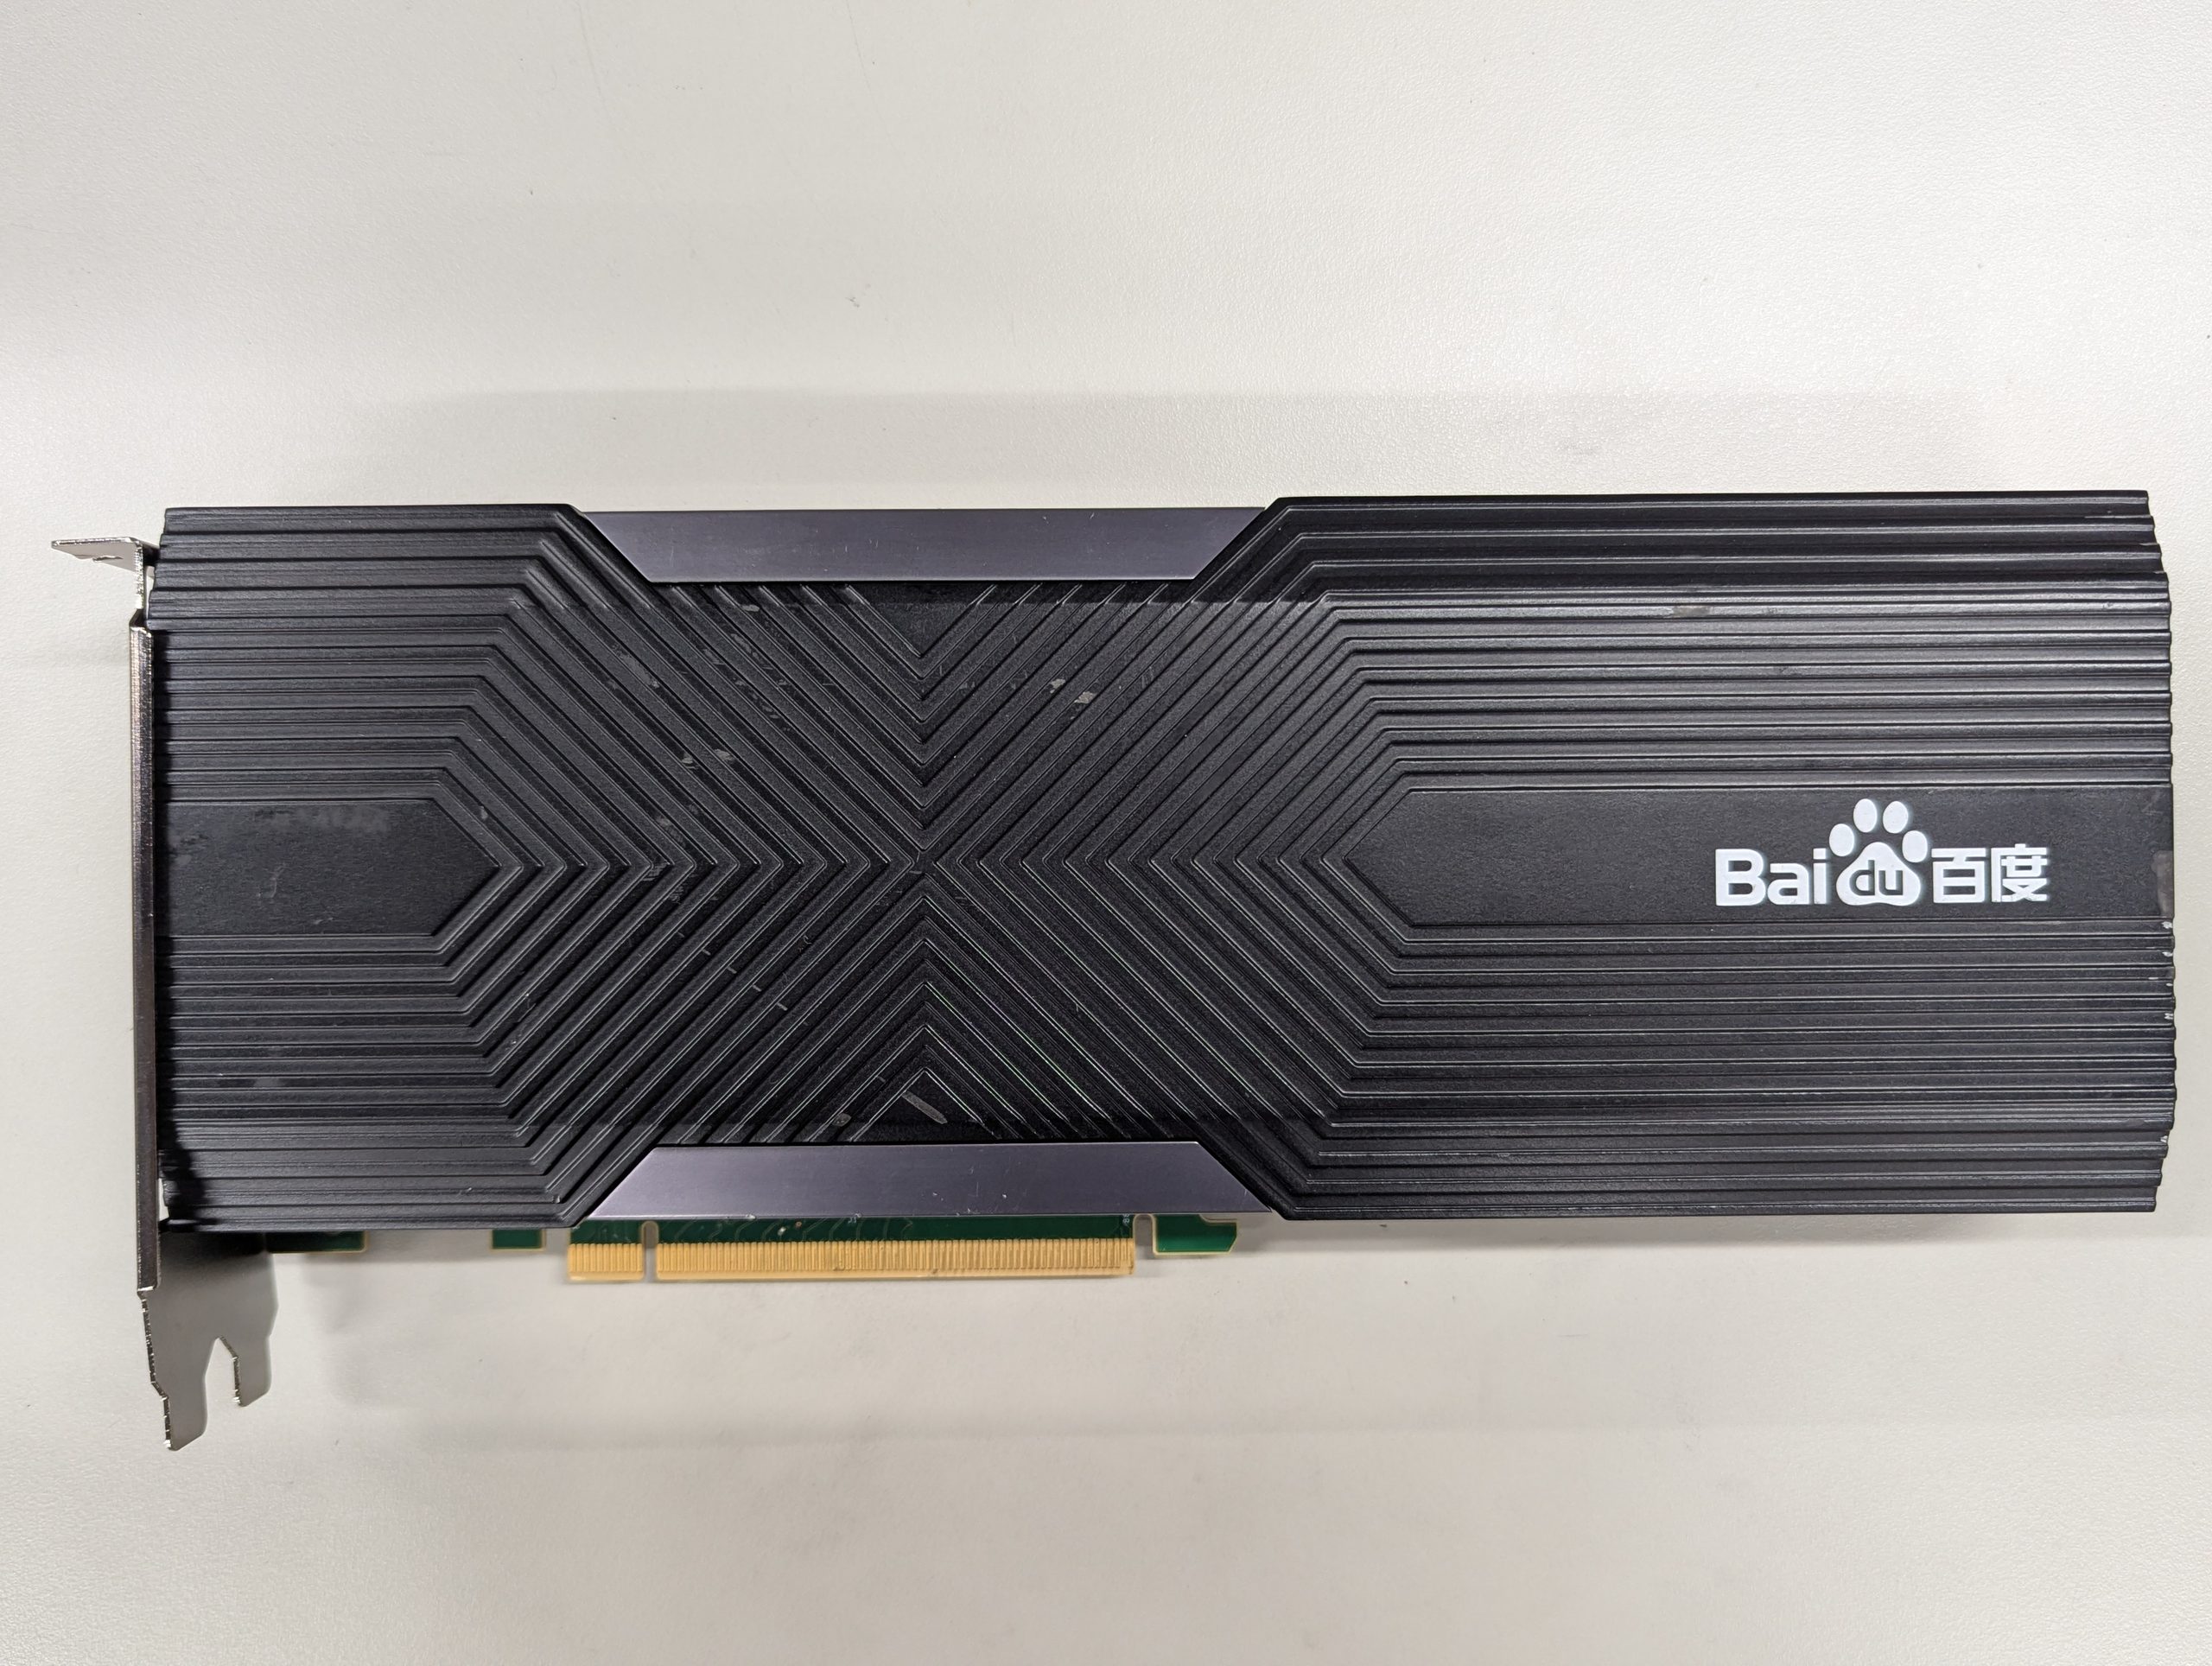
ローカルLLMをやりたい→VRAMの多いGPUが必要→お金ない→AliExpressでKunlun K200という謎激安GPU?を見つける→何故か手元にある
製造元、歴史、概要
Samsungファンドリ製造、14nmプロセス
1チップは2つのユニット(PD)から構成
1つあたり256GB/sの帯域のHBMを2つ搭載
INT8:256TOPS
INT/FP16:64TOPS
INT/FP32:16TOPS
PCIe Gen4 x8接続
TDP150W
Baidu自体が2010年頃からAIアクセラレータの研究を行っています。はじめの方はFPGAを使ったアクセラレータを開発しており、初めて専用チップで製造したのが、今回のKunlun K200です。
Kunlun K200のアーキテクチャ
HotChip 2020でBaiduが資料をあげています。
IEEE ISSCC 2021にKunlun K200についての論文が上がっています。

1のCompute unit(PD)は4つのSDNN(Software Defined Neural Network)(SD)と、4つのClastaer(CL)から構成されます。Clasterには16個のTiny Coreが入っています。これらSDNNとClasterはNoCで接続されています。Shared memoryは16MiBでHBMの2倍の帯域を持っています。PD間は256GB/sのNoCで接続されています。

SDNNは2つの入力DMA、入力データエンジン、行列積和演算を行うMAC(Multiply-Accumulate)アレイ、出力データエンジン、1つの出力DMA、各所バッファで構成されます。
DS_0、SD_1はデータの配置転換を行い、EWは要素演算(Elementwise)とActivationなどができます。RSでは出力の配置転換を行います。
基本的には整数の計算のみができます。小数の場合は、整数に量子化して計算されます。その時の最大値の探索に時間がかかるため整数と比較して少数はオーバーヘッドが大きいです。
MACの演算能力はFP/INT16に比較してINT8は4倍高速とります。
それぞれのエンジンを制御するためのコアが各SDNNに8個あります。これを使用してパイプラインを組むことができます。

Clusterは16個のTiny Core、共有メモリ、SFU(Special Function Unit)、DMAからなり、各Tiny CoreはScalar UnitとVector Unit、ローカルメモリから構成されます。ScalarとVector Unitは同時に使用することができます。Scalar Unitはスカラ小数、整数演算ができ、Vector Unitは256bitのFP32×8のSIMDが使えます。FP16×16やINT16やINT8のSIMDはできません。SFUはlog、exp、sqrt、div、powなどの特殊演算を扱う計算ユニットでCluster内で共有で1つあります。GPUのSIMTとは異なり各Tiny Coreは異なる命令を実行できます。
周辺ソフトウェア
公式
・baidu/vLLM-Kunlun
Kunlun3 P800専用であり、Kunlun K200には対応していない。しかしながら、似たようなアーキテクチャを採用しているため参考になる
・PaddlePaddle/Paddle
ディープラーニングの開発プラットフォーム。Kunlun K200が(過去)対応していた
SDKなどはPaddlePaddleのサイトに残っているので、ありがたい
・
非公式
・mobius/kunlun_k200
Linux向けの改善されたドライバを提供している。
・UnagiDojyou/kunlunK200_Driver
mobius/kunlun_k200のフォーク、NoCを使った高速PD間通信やLinux7のカーネルに対応させたもの
・sam6321/KunlunK200
Kunlun K200で高速なGEMMを行っている。ドキュメントなどもまとまっている
・UnagiDojyou/kunlunK200_lib
sam6321/KunlunK200のフォーク、LLMに必要な各種演算を高速に行うためのライブラリ
・UnagiDojyou/kunlunK200_llama.cpp
llama.cppをKunlun K200で動作させるためのプロジェクト
用語解説
SDNN(SD):Software Defined Neral Network、ニューラルネットワーク用のプロセッサ
CDNN:SDK、ドライバでのSDNN関連の呼称
CL:Clusterのこと
PD:SDNN4つ、Cluster4、16MiB共有L3メモリからなるユニットのこと。Kunlun K200は2つのPDがある
MAC:Multiply-Accumulate
XTDK:開発者ツール、コンパイルなど、CUDA Toolkit的なもの
XRE:ランタイム、CUDA Runtimeみたいなもの
XDNN:Kunlu用ニューラルネットワーク向けライブラリ
DMA:Direct Memory Access、CPUを返さずにメモリへのアクセスができるようにするもの