結論
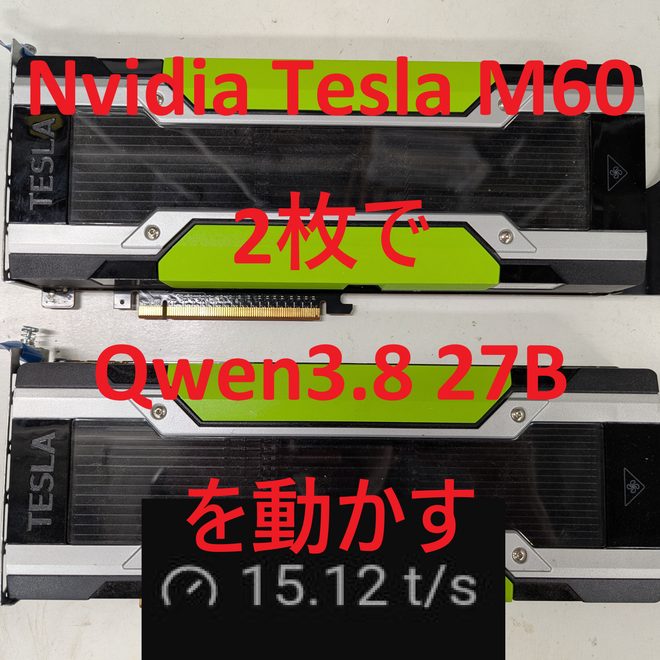
理論通りToken Generation(Decode)ではP100 2枚のの半分くらいの性能が出る。
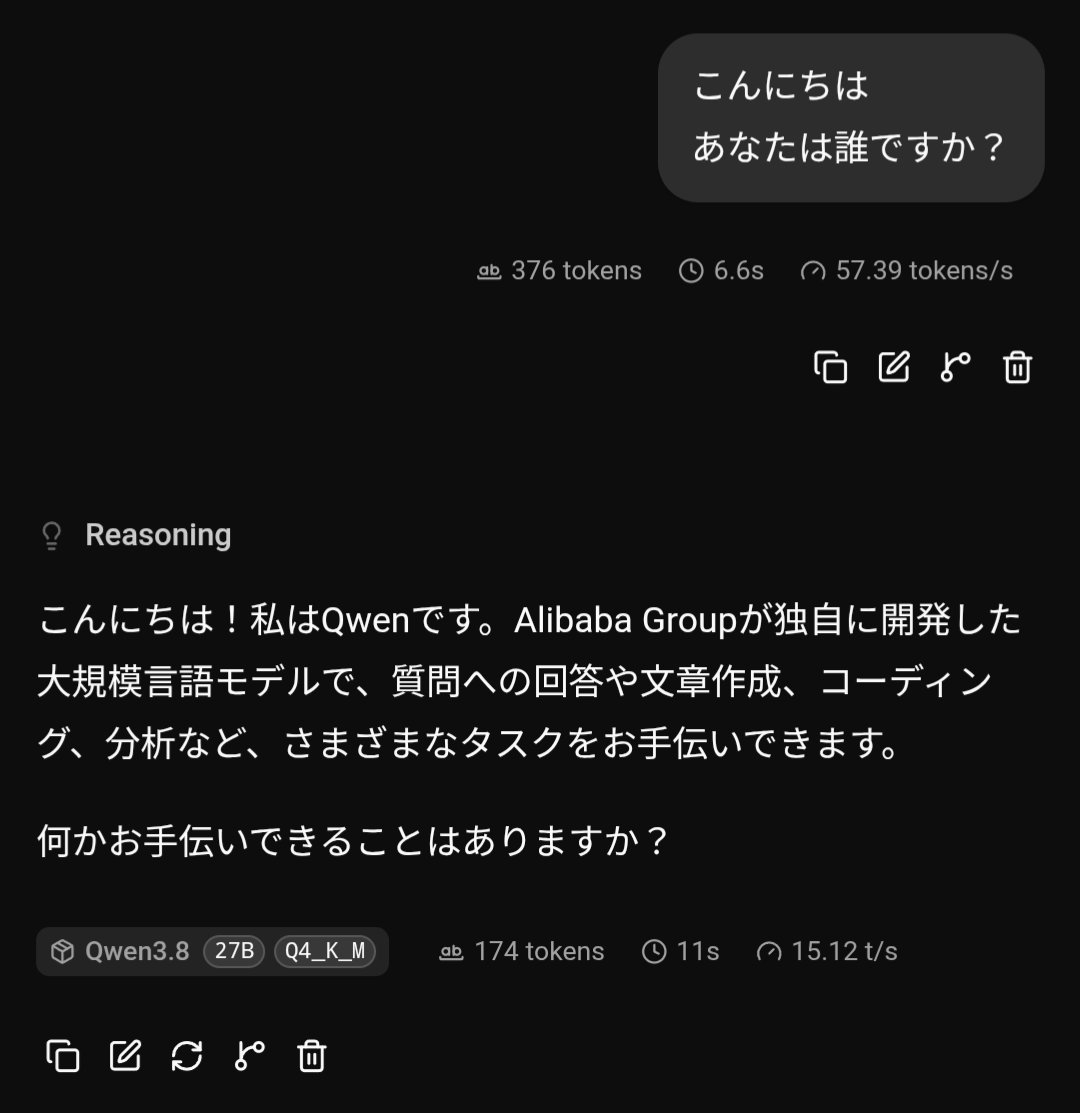
Prompt Processing(Prefill)で57t/s、Token Generationで15t/sとなりました。
きっかけ
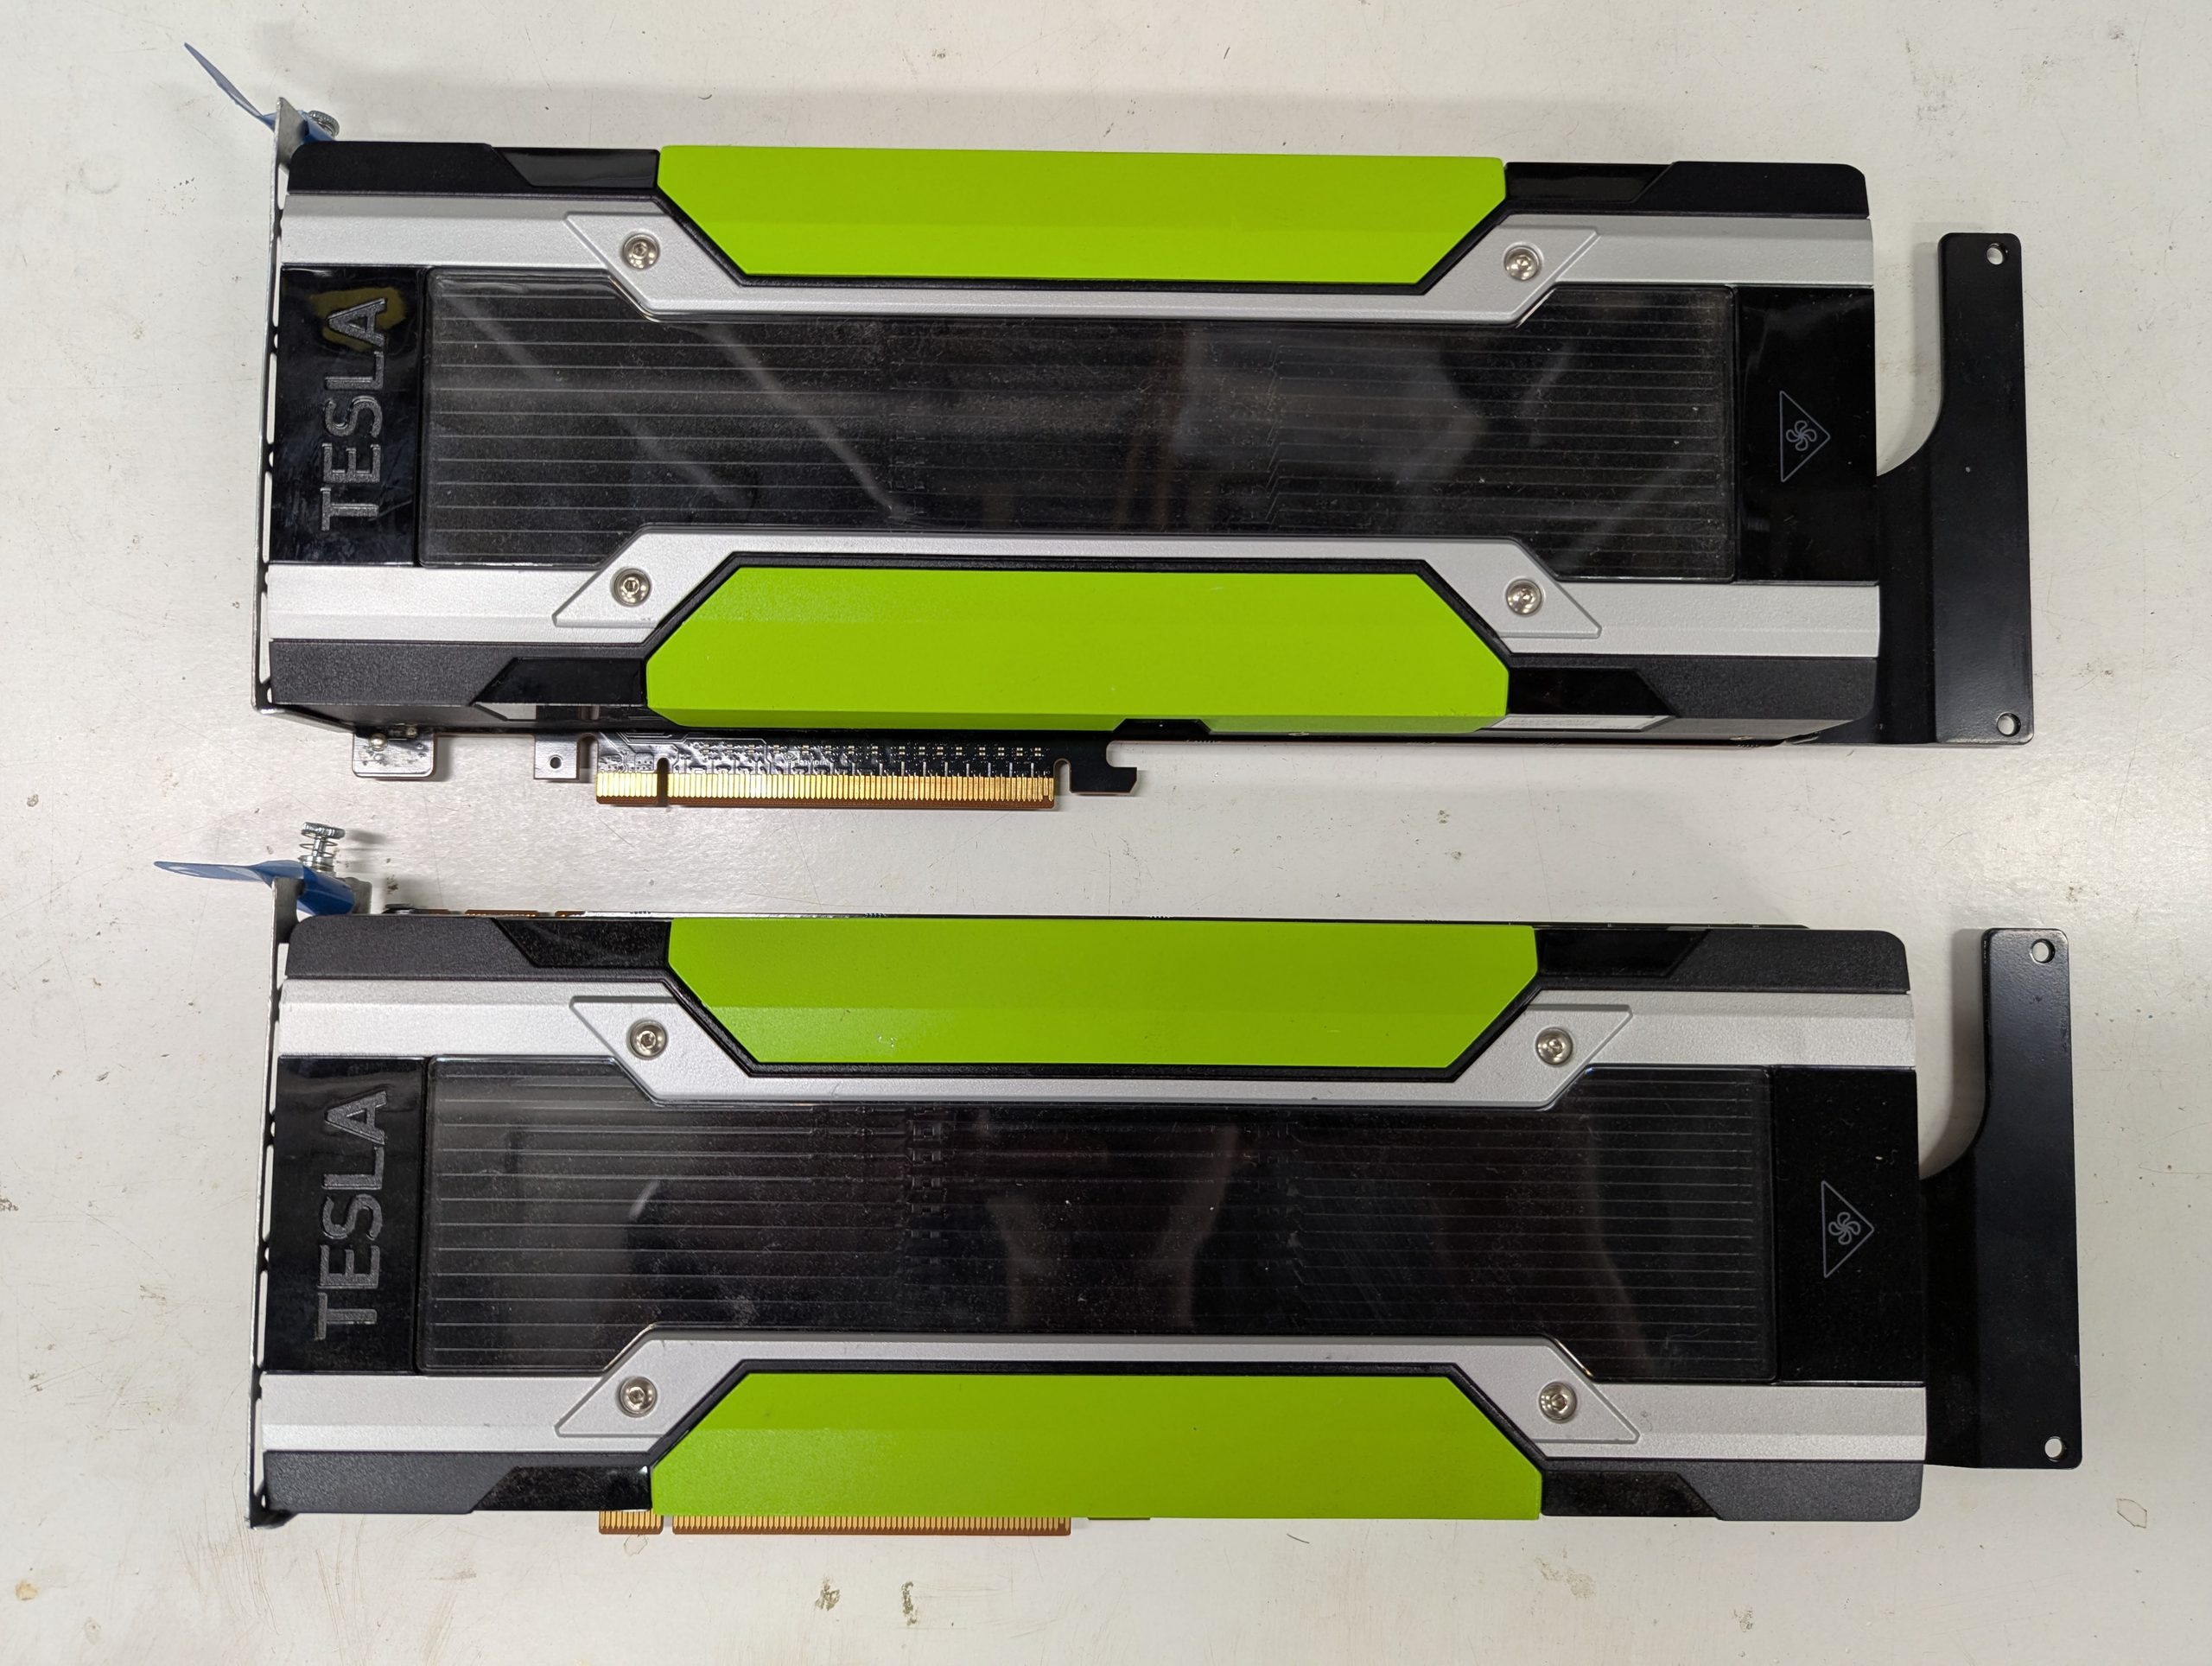
ローカルLLMをしようと思いVRAMの多いGPUを探していたろころ、Tesla M60というのをヤフオクで見つけました。適当に2枚(友人が)ポッチったので使えるようにしてみました。
環境
・Tesla M60は2枚ともPCIe Gen3 x16で接続
・Proxmox上のDebian(LXC)
・Lamma.cpp v0.41
・Qwen3.8-27B-Q4_K_M
・パッチの適用
・Tensor Parallel
・KVキャッシュはQ8
・ドライバ 580.173.02
搭載したコンピュータはこれです↓
友人の力を借りつつ、あり合わせ+格安GPUでLLM用のGPUサーバを構築! もう一枚追加予定 https://t.co/hT0tYEvol7
— Unagi Dojyou (@Unagi_Dojyou) August 21, 2026
M60向けに行ったこと
P100向けに公開されているパッチ
shinbunbun/llama-cpp-p100-patches
を一部適用しました。
02 / 04 / 10 / 11 / 13 / 14 / 16 / 17 / 18 / 21 / 22 / 23 / 24 / 25 / 26 / 27 を適用しました。
llama.cppの起動パラメータは以下の通りです。
--model /mnt/models/Qwen3.8-27B-Q4_K_M.gguf
--host 0.0.0.0 --port 8080
--split-mode tensor --fit off --gpu-layers 999
--ctx-size 262144 --parallel 1
--threads 1 --threads-batch 8
--batch-size 512 --ubatch-size 128
--cache-type-k q8_0 --cache-type-v q8_0 --flash-attn on
全層をGPUに載せ、tensorスプリットを行いました。コンテキストはQwen3.8 27Bのディフォルト最長の262kです。
詳しくはCodexがまとめてくれたllamacpp_for_TeslaM60.mdがあるので、それを見てみてください。
おわりに
15t/sも出れば十分だと思います。もともとは5t/sとかしか出ていませんでしたが、Tensor Parallelができるようになって劇的に早くなりました。