きっかけ
ローカルLLMをやりたい→VRAMの多いGPUが必要→お金ない→AliExpressでKunlun K200という謎激安GPU?を見つける→何故か手元にある
製造元、歴史、概要
Samsungファンドリ製造、14nmプロセス
1チップは2つのユニットから構成
1つあたり256GB/sの帯域のHBMを2つ搭載
INT8:256TOPS
INT/FP16:64TOPS
INT/FP32:16TOPS
PCIe Gen4 x8接続
TDP150W
Baidu自体が2010年頃からAIアクセラレータの研究を行っています。はじめの方はFPGAを使ったアクセラレータを開発しており、初めて専用チップで製造したのが、今回のKunlun K200です。
Kunlun K200のアーキテクチャ
HotChip 2020でBaiduが資料をあげています。
IEEE ISSCC 2021にKunlun K200についての論文が上がっています。
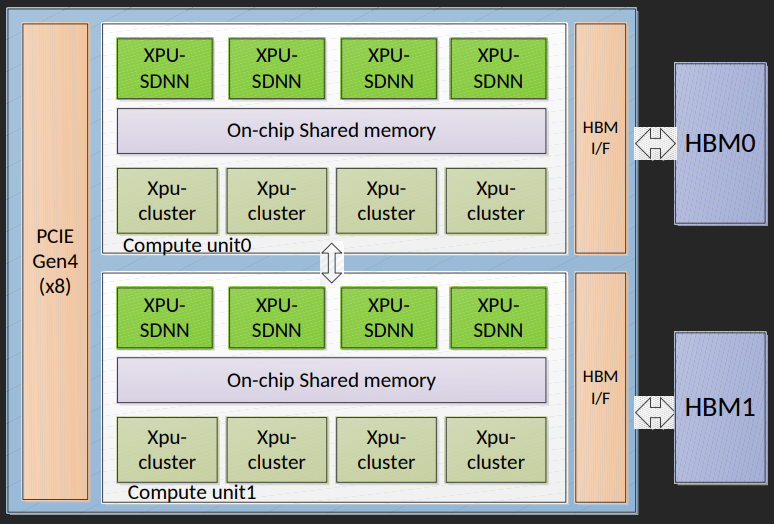
1のCompute unit(PD)は4つのSDNN(Software Defined Neural Network)と、4つのClastaerから構成されます。Clasterには16個のTiny Coreが入っています。これらSDNNとClasterは16MBの共有メモリで接続されています。
SDNNは2つの入力DMA、入力バッファ、行列積和演算を行うMAC(Multiply-Accumulate)アレイ、Elwmentwise演算・Activationエンジン(EW)、出力バッファ、1つの出力DMAで構成されます。
Clusterは16個のTiny Core、共有メモリ、DMAからなり、各Tiny CoreはScalar UnitとVector Unit、ローカルメモリから構成されます。Scalar UnitではALUとSFU、Vector Unitは256bitのSIMDが使えます。GPUのSIMTとは異なり各Tiny Coreは異なる命令を実行できます。
用語解説
SDNN:Software Defined Neral Network、ニューラルネットワーク用のプロセッサ
CDNN:不明
MAC:Multiply-Accumulate
XTDK:開発者ツール、コンパイルなど、CUDA Toolkit的なもの
XRE:ランタイム、CUDA Runtimeみたいなもの
DMA:Direct Memory Access、CPUを返さずに